October 06, 2026
Desplegar un agente de IA en producción: Vercel vs Modal
¿Dónde corre un agente de IA cuando lo llevas a producción? Durante el último año mi respuesta ha sido estable: el producto web va a Vercel y el agente en sí va a Modal, una plataforma serverless construida para trabajo de Python y GPU de larga duración. Este artículo explica ese reparto, con los límites y los precios que hay detrás de la decisión.
No voy a cubrir frameworks de agentes ni diseño de prompts. Asumo que ya tienes un loop de agente funcionando, llamadas al modelo más herramientas, y que la pregunta es dónde desplegarlo. Si nunca has usado Modal, no pasa nada, te enseño el código que despliega un agente real allí.
Sigo recomendando Vercel, y lo uso cada semana en proyectos de clientes. Es el sitio correcto para la capa de aplicación: las páginas, la autenticación, las API routes. Modal se encarga de la parte para la que Vercel no está construido: la computación que la app dispara. Los dos funcionan mejor juntos.
Lo que un agente le pide a un runtime
Un agente es un loop, no un request handler. Un mensaje de usuario puede convertirse en una docena de llamadas al modelo, ejecuciones de herramientas y reintentos antes de tener una respuesta que merezca la pena devolver. Desde el punto de vista del runtime, ese loop exige cuatro cosas:
- Ejecuciones largas. Una tarea de investigación o de código tarda minutos por mensaje de usuario sin despeinarse.
- Inicialización pesada. El primer import de
torch, o la primera carga de un índice de retrieval, puede costar segundos por sí solo. - Estado que merece la pena conservar. Ese índice cargado, y a menudo la memoria de sesión, ahorra trabajo en cada turno posterior. Tirarlo después de cada request es un desperdicio.
- Concurrencia irregular. Un mensaje de usuario puede ramificarse en varias ejecuciones de herramientas en paralelo. El tráfico llega en picos, no en un flujo constante.
Nada de esto encaja con lo que una función serverless orientada a requests está pensada para hacer: procesar un evento rápido, salir y dejar que la plataforma recicle todo.
Dónde empieza a doler Vercel
Vercel Functions con Fluid compute mejoró de verdad para agentes. Las instancias se reutilizan entre requests en lugar de morir después de cada uno, y la facturación pasó a Active CPU, que se pausa mientras tu código espera en I/O. Un loop de agente pasa la mayor parte del tiempo esperando a la API de un modelo, así que ese modelo de precios le sienta bien a los agentes.
Después llegan los límites. La duración máxima por defecto son 300 segundos en todos los planes. Hobby no puede pasar de ahí. Pro y Enterprise llegan a 800 segundos, con un máximo extendido de 1800 en beta desde junio de 2026. Cinco minutos cubren un agente de chat. No cubren un agente que navega, ejecuta código y reintenta sus propios errores, y el modo de fallo es feo: un 504 en mitad de una ejecución, con el loop y su estado perdidos.
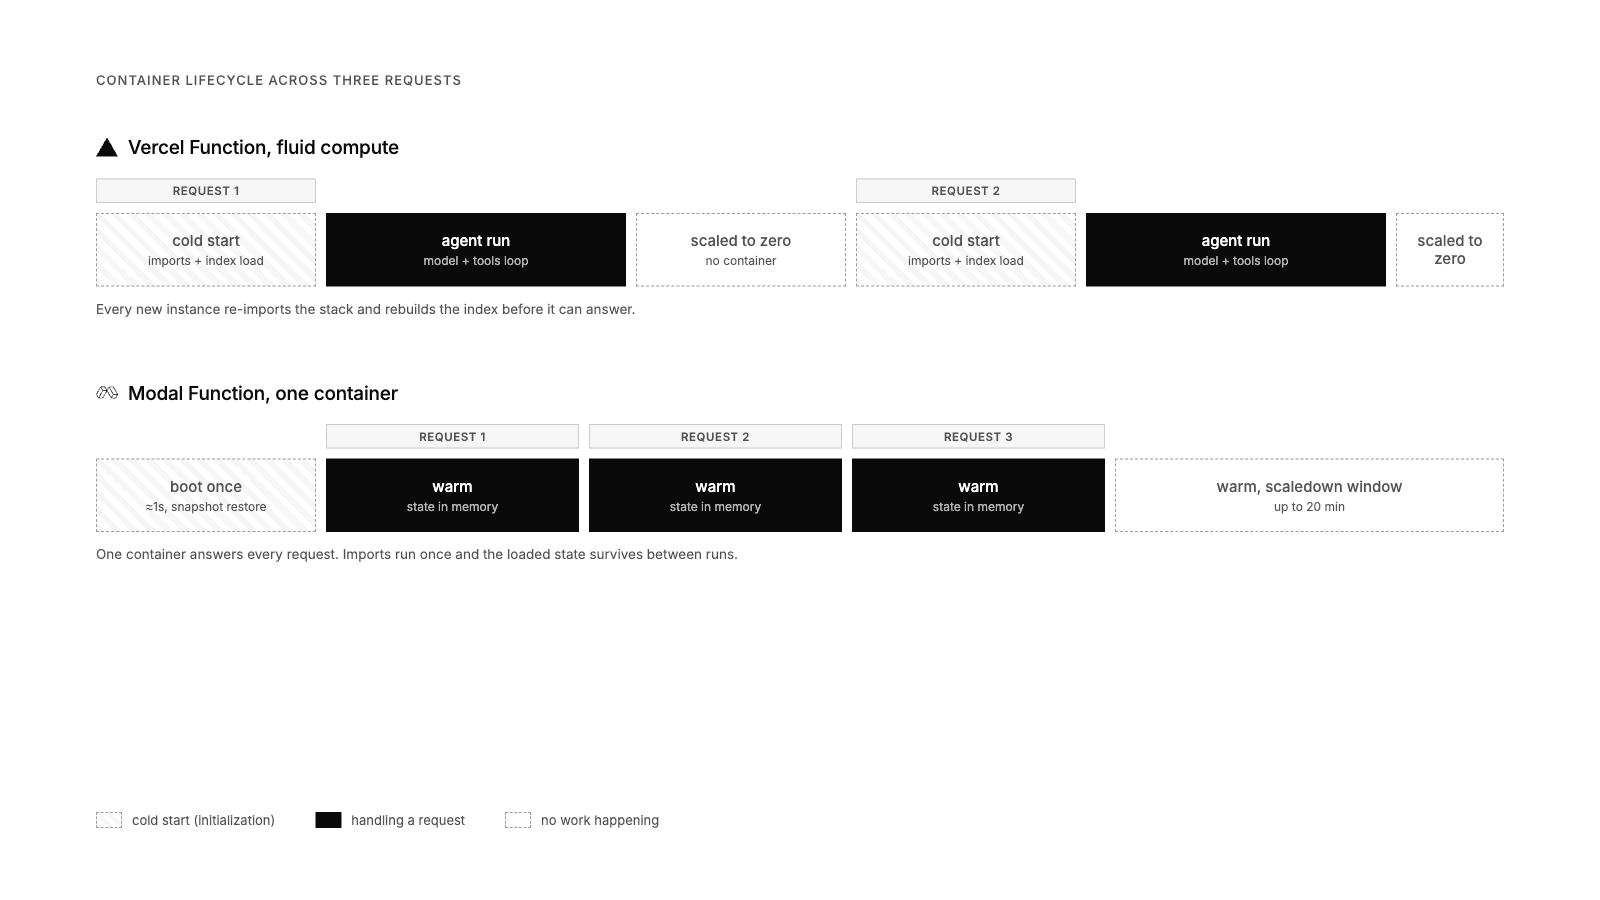
El cold start es el segundo problema. Fluid compute reutiliza instancias, pero cuando el tráfico sube, arrancan instancias nuevas, y cada arranque vuelve a ejecutar el scope global: los imports, la carga del índice, la configuración de clientes. En una app web ese coste son unos pocos cientos de milisegundos. En un stack de agentes con dependencias pesadas de Python son segundos, y caen justo en los requests que más te interesaba que fueran rápidos.
El resto se resume rápido. La memoria llega como máximo a 2 GB en Hobby y 4 GB en Pro, con 1 y 2 vCPUs asociados. No hay GPUs en Vercel Functions. Y las funciones corren en una sola región por defecto.
Vercel sí tiene una respuesta para la duración: Workflows, que puede pausarse y reanudarse, y mantener estado de minutos a meses. Si ya estás metido de lleno en el stack de Vercel, míralos. Lo que resuelven es la duración; el coste de inicialización y un contenedor caliente con estado siguen siendo tu problema.
Por qué ejecuto agentes en Modal
Modal define serverless alrededor de contenedores en lugar de requests. Escribes Python, decoras una función o una clase, y modal deploy lo convierte en un despliegue con autoescalado y URL. Plantearlo así mueve todos los números que dolían antes:
- Duración. El timeout por defecto son 300 segundos, pero cualquier función puede configurar entre 1 segundo y 24 horas. Ningún plan limita ese número. Una ejecución de agente de una hora es un argumento.
- Cold starts. Un contenedor arranca en aproximadamente un segundo, y los memory snapshots de Modal se saltan el trabajo de inicialización en la mayoría de arranques. Modal midió un
import torchpasando de unos 5 segundos a unos 1, y una función de Stable Diffusion de 13 segundos a 3.5. Las funciones con inicialización pesada suelen arrancar 3 a 10 veces más rápido. - Calor. Lo controlas tú.
scaledown_windowmantiene un contenedor vivo entre 2 segundos y 20 minutos después de su último input, ymin_containersmantiene un mínimo de contenedores corriendo siempre. - Estado. Un contenedor caliente es un sitio donde un índice cargado y una sesión pueden simplemente vivir en memoria, con Volumes para lo que tiene que sobrevivir a los reinicios.
- GPUs. Un argumento en el decorador, de una T4 a una B300, hasta 8 por contenedor. Tu agente solo necesita una cuando la necesita.
- Un sitio para el código que escribe el agente. Los Sandboxes son contenedores aislados para el código que un agente genera y ejecuta, con filesystem snapshots para guardar el estado de una sesión. Modal es uno de los proveedores oficiales de sandbox del OpenAI Agents SDK, junto a Vercel, E2B y algunos más.
- Precios. Todo se factura por segundo: una H100 a 3.95 $ por hora de uso real, la CPU a 0.0000131 $ por core-segundo. El plan Starter cuesta 0 $ e incluye 30 $ de computación cada mes, lo que da para bastante tráfico de agentes mientras sigues construyendo.
Modal no es la única opción en este espacio. RunPod y Baseten se centran en GPUs serverless para modelos, Replicate en servir inferencia de modelos, E2B en sandboxes para agentes. Yo elijo Modal porque cubre al agente completo: el loop, el sandbox donde el agente ejecuta código y la GPU cuando el trabajo la necesita. Y su documentación es lo bastante profunda para que el equipo de un cliente encuentre sus propias respuestas cuando yo ya no esté, lo cual es parte de cómo elijo cualquier plataforma.
Vercel vs Modal, lado a lado
| Lo que importa para un agente | Vercel Functions | Modal |
|---|---|---|
| Ejecución más larga | 300s en Hobby, 800s en Pro, 1800s en beta | Cualquier valor de 1s a 24h, por función |
| Cold start en una instancia nueva | Repite imports y setup en cada instancia nueva | Arranque de contenedor en torno a 1s, los memory snapshots se saltan los imports |
| Calor entre requests | Reutilización de instancias, sin garantía | scaledown_window hasta 20 min, min_containers |
| Estado entre requests | Almacén externo obligatorio (base de datos, Redis) | En memoria en un contenedor caliente, más Volumes |
| Techo de memoria | 2 GB en Hobby, 4 GB en Pro | Cualquier tamaño de contenedor, GPUs incluidas |
| GPUs | Ninguna | De T4 a B300, hasta 8 por contenedor |
| Ejecución de código del agente | Producto Sandbox aparte | Sandboxes integrados, con filesystem snapshots |
| Precios | Active CPU + memoria aprovisionada + invocaciones | CPU, GPU y memoria por segundo, 30 $/mes incluidos en Starter |
| Lenguajes | Node.js, Bun, Python (TypeScript primero) | Python, TypeScript, Go |
Cómo se ve el código
En Vercel, el agente vive en un route handler con una duración que negocias con el plan:
export const maxDuration = 800; // Plan Pro. Hobby se queda en 300s.

export async function POST(req: Request) {
  const { messages } = await req.json();

  // Una llamada al modelo estaría bien. Un loop de herramientas
  // con reintentos es lo que convierte esto en un riesgo de timeout.
  const result = await runAgent(messages);

  return Response.json(result);
}
En Modal, el agente es una clase con sus recursos y su ciclo de vida a la vista:
import modal

app = modal.App("research-agent")
image = modal.Image.debian_slim().pip_install("pydantic-ai")

@app.cls(
    image=image,
    secrets=[modal.Secret.from_name("openai-api-key")],
    timeout=3600,               # 1 hora por ejecución, sin subir de plan
    scaledown_window=15 * 60,   # mantenerse caliente 15 minutos tras el último input
    min_containers=1,
    enable_memory_snapshot=True,
)
@modal.concurrent(max_inputs=16)
class ResearchAgent:
    @modal.enter(snap=True)
    def load(self):
        # Corre una vez por contenedor y queda dentro del memory snapshot.
        self.index = build_index()

    @modal.method()
    async def run(self, question: str) -> str:
        return await agent_loop(self.index, question)
Un comando lo despliega, construye la imagen cuando cambia y gestiona la transición de versión:
modal deploy research_agent.pyEl despliegue recibe una URL a la que puedes llamar desde tu app con @modal.web_server o @modal.fastapi_endpoint, así que el route handler de Next.js sigue haciendo lo que se le da bien, autenticación y streaming, y reenvía la ejecución a Modal.
Una cosa a vigilar: prueba los memory snapshots fuera de producción primero. Modal lo recomienda hasta que tu configuración haya demostrado estabilidad entre restauraciones.
Cuándo basta con Vercel
Si tu agente responde en una o dos llamadas al modelo, o con un loop de herramientas que se queda por debajo de cinco minutos, Vercel solo es una respuesta perfectamente válida, y la sencillez operativa de una sola plataforma vale más que todo lo que Modal añade. Ese es el caso de la mayoría de funcionalidades de chat con tus datos.
Mi regla práctica: en el momento en que un agente corre minutos, ejecuta el código que escribe o carga algo más pesado que un SDK de cliente, se ha ganado su propio despliegue. Esta es la arquitectura que entrego yo: la app en Vercel, el agente en Modal, hablando por un endpoint:
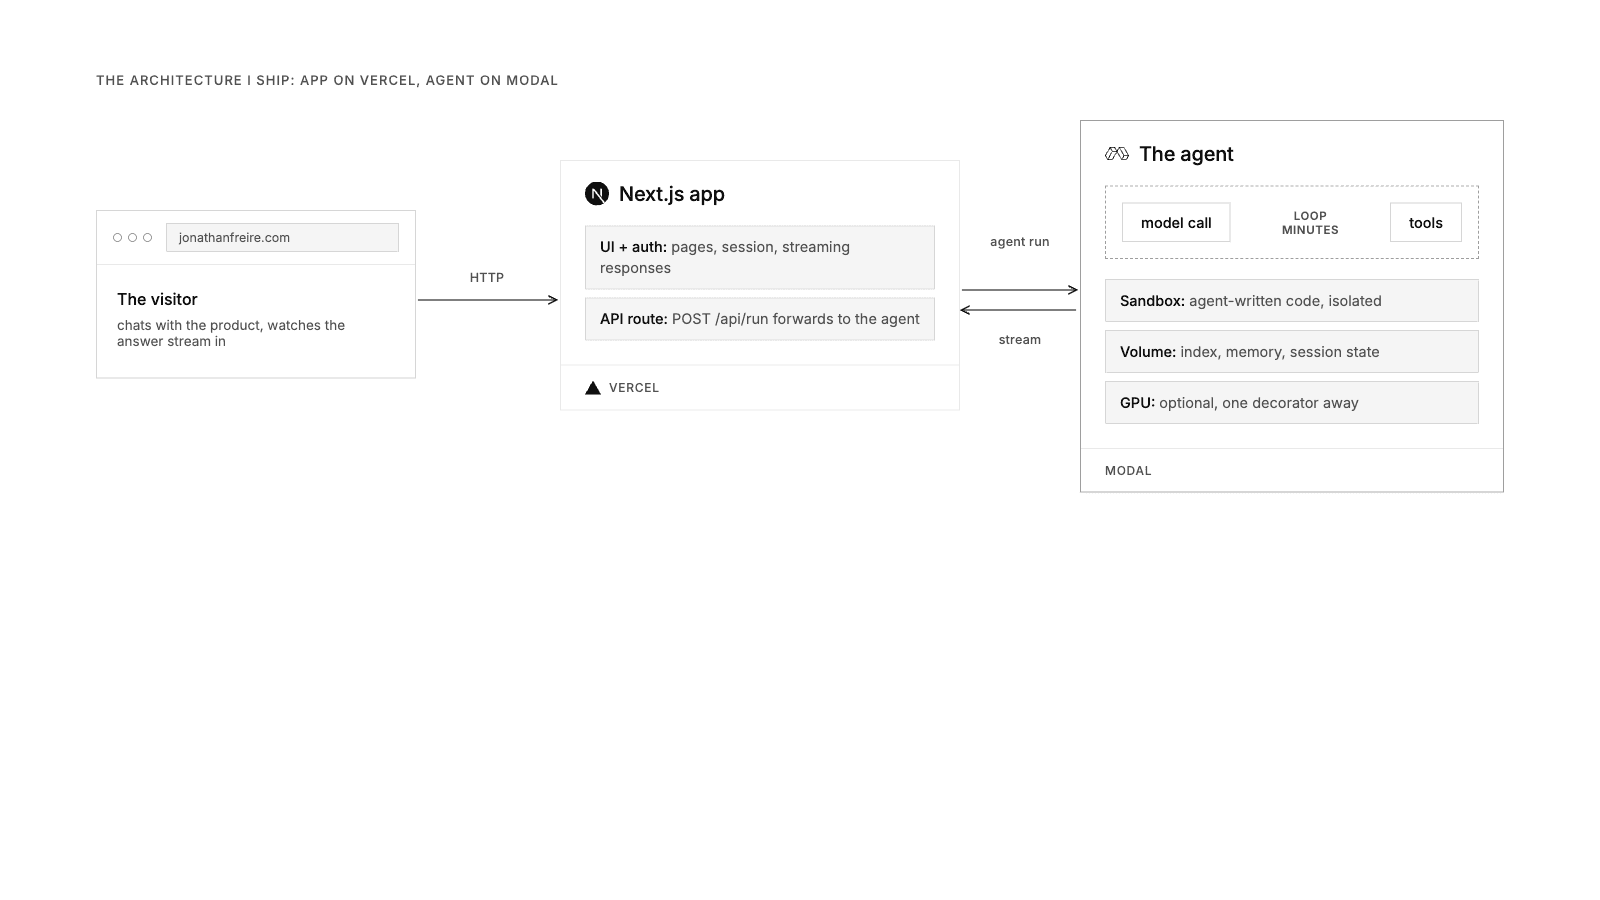
Este reparto deja intacto el stack con el que entrego productos web. La app simplemente llama a un HTTP endpoint, igual que llamaría a cualquier otro servicio interno.
Conclusión
Vercel y Modal hacen trabajos distintos. Vercel es donde vive el producto. Modal es donde trabaja el agente. Los límites que deciden la cuestión son duración, cold starts y estado, y en esos tres, Modal gana para cualquier agente cuyas ejecuciones se midan en minutos.
El trade-off honesto: asumes una segunda plataforma, un segundo pipeline de despliegue y, en la práctica, un código en Python junto al tuyo en TypeScript. Si tus agentes son cortos y tu equipo quiere un solo proveedor, quedarte en Vercel, con maxDuration alto y Workflows donde necesites durabilidad, es una elección defendible.
Si quieres ver un agente completo en Modal, incluido el sandbox donde el agente ejecuta su propio código, empieza por su ejemplo de agente de código. Es el ejemplo que enseño a los clientes cuando surge este reparto, y corre en el plan Starter gratuito.